PG关注到,研华10月14日发布边缘AI推理专题,介绍在相机、工业计算机和本地服务器附近运行已训练模型的方式。数据可以在产生位置附近被处理,再把事件或摘要交给其他系统,而不必持续上传全部原始输入。
这类架构常被用于需要及时反馈的视觉与传感器任务。不过,本地运行只是部署位置的选择,应用是否满足需求,还要看采集、分析和结果交付的整条链路。
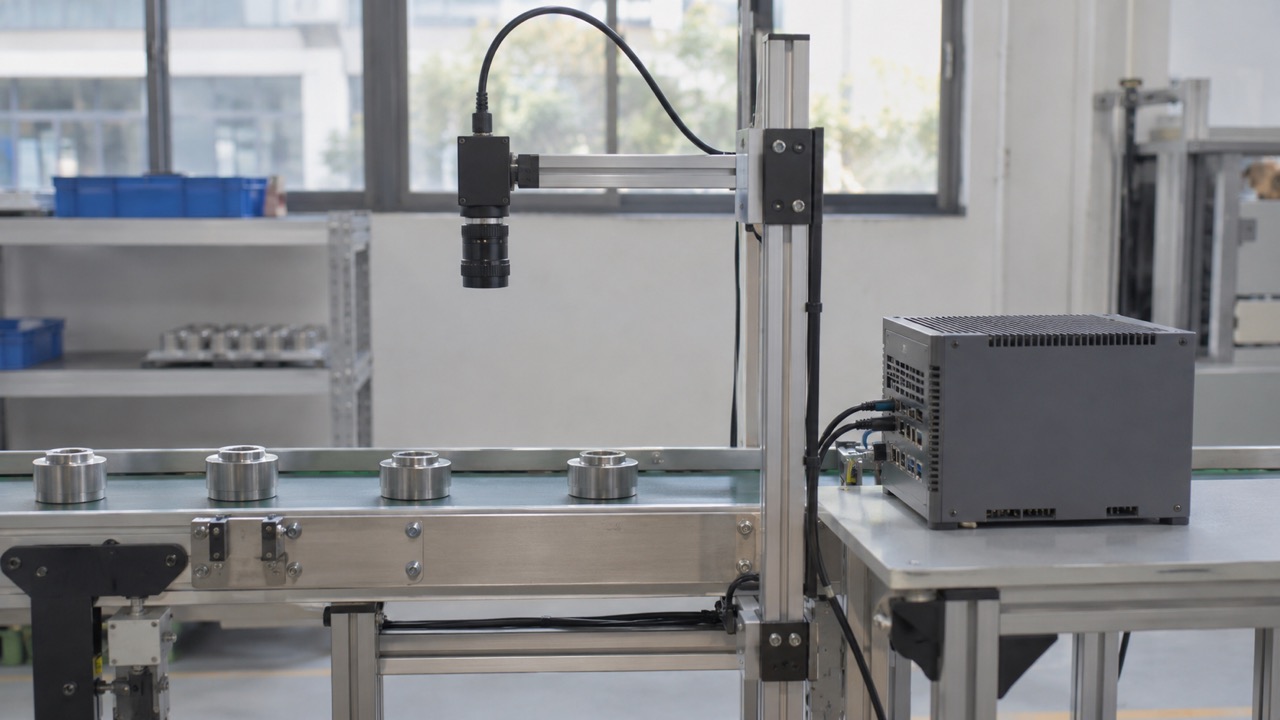
训练形成模型,推理处理新的输入
研华在专题中区分了训练与推理:前者利用历史数据形成模型,后者将模型用于新输入。边缘推理关注的是模型在现场怎样接收数据、完成计算并交付结果。
理解这一区别,有助于明确项目的工作分工。现场发现识别异常以后,问题可能来自模型,也可能来自采集条件或输入格式变化。排查时先确认新数据经历了怎样的处理过程,可以避免把所有异常都归因于训练环节。
模型输入与现场图像之间也需要保持对应。裁剪区域、缩放方式和颜色处理一旦变化,进入模型的数据就可能与验证时不同。保留这些处理配置,能够帮助团队判断一次变化究竟发生在什么位置。
响应速度,需要从输入开始计时
边缘侧处理能够减少往返远端服务器的环节,但总响应时间仍由多个步骤组成。相机采集、数据排队、预处理、模型计算和后续系统接收结果,都会占用时间。
因此,比较两种配置时,可以先约定相同的任务起点与终点。只记录模型执行时间,无法完整反映图像已经产生但仍在排队的等待。把各阶段分别记录下来,更容易发现真正限制任务速度的位置。
对于连续输入,还需要观察处理速度变化后的表现。如果短时输入超过系统能力,应用如何标记积压、如何说明未处理的数据,都应当有清楚规则。否则,较快的单次计算结果可能掩盖持续运行中的等待问题。
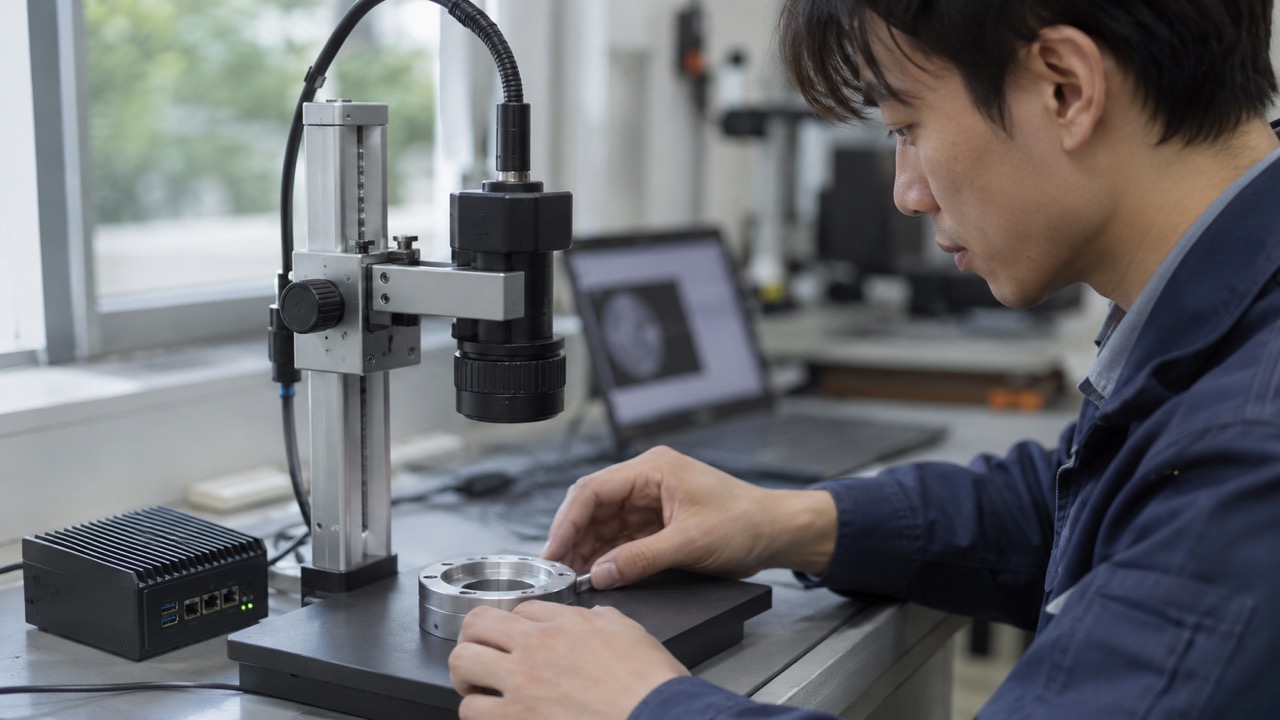
本地保留数据,也需要明确记录用途
专题提到,现场处理可以减少原始视频传输,让部分数据留在本地。对项目而言,这也带来进一步的设计问题:哪些记录用于日常统计,哪些片段用于复核,谁能够访问,以及何时清理。
只保留一个结果标签,有时不足以解释后续争议;无差别保留所有输入,又可能增加存储与管理压力。围绕实际复核需求确定记录范围,可以让数据留存与运维工作保持对应。
当多个工位共同参与同一流程时,时间与任务编号也要能够关联。这样,查看一次检测结果时,才能找到对应输入、设备状态和后续处理记录,让结果具有可追溯的上下文。
结果能够被正确使用,任务才算闭合
模型发现一个目标,与业务系统正确使用这个结果,是两个需要衔接的步骤。项目应当明确输出格式、接收方和失败状态;对于无法确定的输入,也需要有预先约定的处理方式。
一次识别任务还可以保留置信信息与复核结果的对应关系。项目需要约定哪些输出能够直接进入后续流程,哪些应当交给人员确认,并通过实际复核记录观察规则是否适用。这比默认所有输入都能得到确定答案更接近日常使用条件。
在PG看来,边缘AI推理的评价重点,可以从单个性能数字扩展到完整任务。数据进入系统以后,结果是否及时、是否可解释、是否被正确交付,这些问题共同决定了本地计算能够带来怎样的实际价值。